"Die KI läuft auf unseren eigenen Servern." Für Steuerberater und Wirtschaftsprüfer klingt dieser Satz wie ein Schlussstrich unter eine unangenehme Debatte. Keine Mandantendaten in einem frei zugänglichen Chatbot. Kein externer Anbieter, der mitliest. Keine Übermittlung in die USA. Volle technische Kontrolle. Kanzleien, die über eigene KI-Anwendungen, lokal betriebene Sprachmodelle oder das Fine-Tuning eines bestehenden Modells nachdenken, halten Self-Hosting deshalb häufig für den datenschutzrechtlich sauberen Weg.
Das ist nicht falsch. Es ist nur die halbe Antwort – und leider die einfachere Hälfte.
Der Serverstandort klärt, wo Daten verarbeitet werden und wer technisch an sie herankommt. Er klärt nicht, ob personenbezogene Daten überhaupt in das Training eines Modells fließen dürfen. Und er klärt erst recht nicht, was geschieht, wenn eine betroffene Person Jahre später verlangt, dass ihre Daten verschwinden.
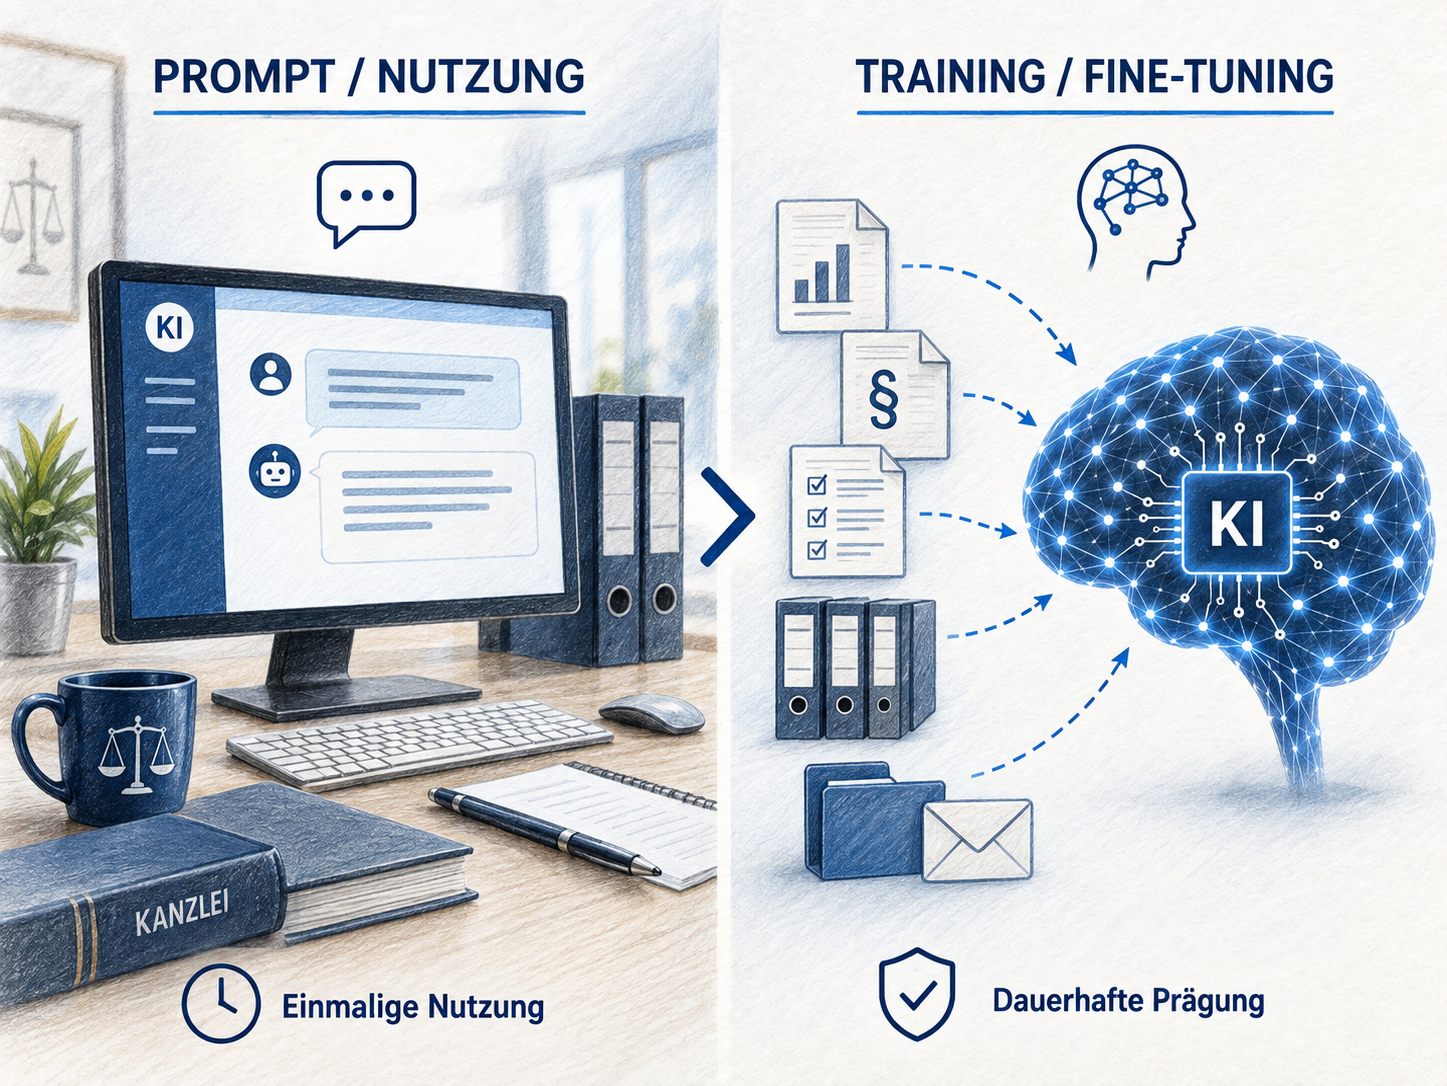
Ein Prompt ist ein Vorgang. Ein Training ist ein Abdruck.
Zwischen dem Einsatz eines KI-Systems und dem Training eines Modells liegt ein qualitativer Unterschied, der in Kanzleiprojekten regelmäßig untergeht. Wer eine Anfrage stellt, lässt Daten verarbeiten, um ein Ergebnis zu erzeugen. Wer trainiert, lässt Informationen in die Parameter des Modells einfließen.
(KI-generierte Illustration)
Der Europäische Datenschutzausschuss geht deshalb ausdrücklich nicht davon aus, dass ein mit personenbezogenen Daten trainiertes Modell automatisch anonym ist; ob noch personenbezogene Daten im Sinne der DSGVO enthalten sind, muss im Einzelfall bewertet werden.
Für Kanzleien ist das keine Randnotiz. In Steuerberatungs- und WP-Praxen liegen Datenbestände, die für KI-Projekte ausgesprochen attraktiv sind: jahrzehntelange Mandantenkorrespondenz, Jahresabschlüsse, Steuererklärungen, Stellungnahmen, Arbeitspapiere, Verträge, Personalakten, Dokumentationen von Betriebsprüfungen. Aus technischer Sicht ein wertvoller Wissensbestand. Aus datenschutz- und berufsrechtlicher Sicht ein Hochrisikofeld.
Sechzehn Jahre Mandantenkorrespondenz – und niemand, der "Wozu?" gefragt hat.
Das folgende Beispiel ist ein typisiertes Szenario, keine Fallstudie: Eine mittelständische Steuerberatungsgesellschaft im süddeutschen Raum, rund 25 Beschäftigte, breiter Mittelstandsmandantenstamm. Nennen wir sie Kanzlei S.
Kanzlei S. will ihre internen Prozesse mit einer eigenen KI unterstützen. Das System soll frühere Stellungnahmen, Mandantenanfragen und kanzleiinterne Fachtexte kennen, Entwürfe für Mandantenantworten erstellen und Mitarbeitende bei der Recherche entlasten.
Die Entscheidung gegen ein öffentliches KI-System fällt bewusst und schnell. Ein sogenanntes Open-Weights-Modell soll auf eigener Hardware im Serverraum laufen – also ein Sprachmodell, dessen trainierte Parameter der Hersteller zum Download bereitstellt, sodass es sich lokal betreiben und weitertrainieren lässt. Bei den bekannten Systemen von OpenAI, Anthropic oder Google ist das nicht möglich: Dort erreicht man das Modell nur über eine Schnittstelle beim Anbieter. Der Zugriff bleibt auf Kanzleimitarbeitende beschränkt, die Daten verlassen nach dem technischen Konzept die Kanzleiumgebung nicht. Damit sind erhebliche Risiken tatsächlich reduziert: Die Prüfung internationaler Datenübermittlungen entfällt weitgehend, die Abhängigkeit von einem externen Anbieter ebenfalls.
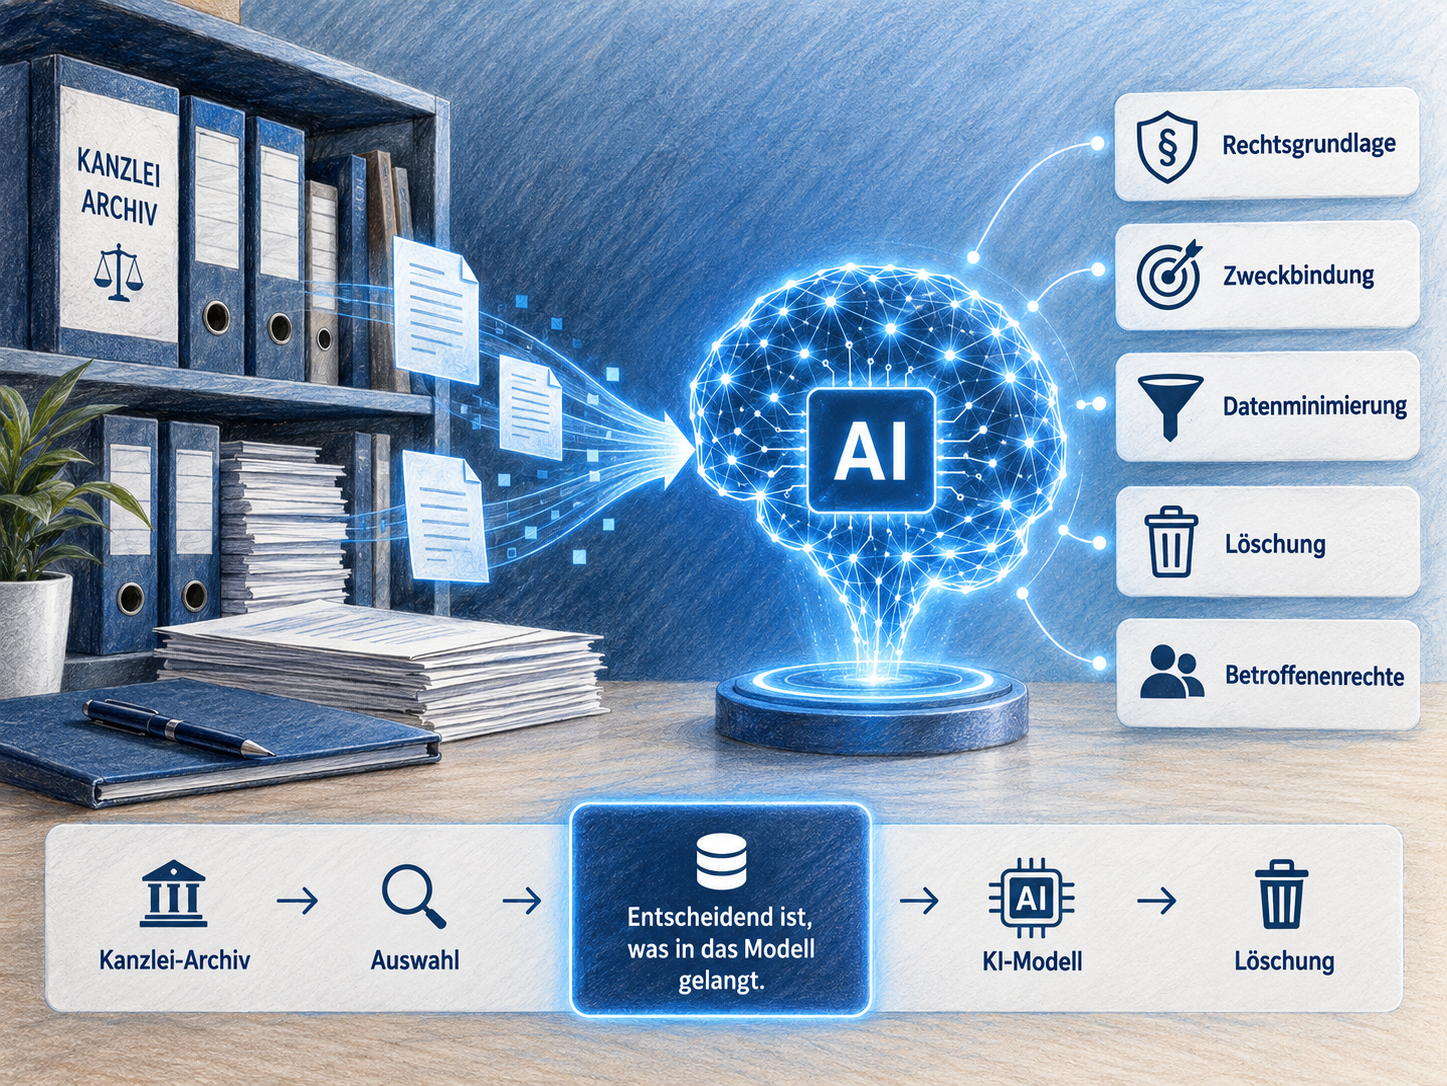
Als Trainingsgrundlage vorgesehen: Das Dokumentenarchiv der Kanzlei. Sechzehn Jahre. Rund 300.000 Dateien.
Und hier beginnt die eigentliche Frage: Welche Daten gehen in das Modell, auf welcher Rechtsgrundlage – und wie kommen sie wieder heraus?
(KI-generierte Illustration)
Self-Hosting schafft keine Rechtsgrundlage. Art. 6 DSGVO gilt im eigenen Serverraum genauso wie in der Cloud. Die deutschen Aufsichtsbehörden haben in ihrer Orientierungshilfe für Entwickler und Betreiber ausdrücklich festgehalten, dass Training, Trainingsdaten und die daraus resultierenden Risiken von Beginn an in die datenschutzrechtliche Gestaltung einzubeziehen sind. Datenschutz durch Technikgestaltung ist damit keine nachgelagerte Dokumentationsaufgabe, sondern eine Architekturentscheidung.
Ein Aktenschrank vergisst auf Kommando. Ein Mitarbeitender, der alles gelesen hat, nicht.
Gibt eine Mitarbeiterin einen zulässigen Sachverhalt in ein KI-System ein, um daraus eine Mandanten-E-Mail zu erzeugen, lassen sich Eingabe und Ausgabe je nach System speichern und wieder löschen.
Fine-Tuning ist etwas anderes. Ein bestehendes Modell wird mit zusätzlichen Daten weitertrainiert, damit es sein Verhalten dauerhaft an einen bestimmten Anwendungsbereich anpasst. Danach liegen die Trainingsinformationen nicht mehr als Datensätze in einer Datenbank, in der man später die Zeile "Mandant Müller" löscht. Muster aus diesen Daten schlagen sich in den Parametern des Modells nieder.
Eine Datenbank ist ein Aktenschrank. Ein trainiertes Modell ist ein Gedächtnis, das sämtliche Akten gelesen hat. Den Aktenschrank kann man ausräumen. Ein Gedächtnis kann man bitten, eine bestimmte Sache zu vergessen – überprüfen lässt sich das Ergebnis nur sehr eingeschränkt.
Genau deshalb hat die Bundesbeauftragte für den Datenschutz und die Informationsfreiheit ein öffentliches Konsultationsverfahren zu "memorisierten" personenbezogenen Daten in KI-Modellen durchgeführt – ausgehend von der Feststellung, dass KI-Modelle personenbezogene Daten enthalten können, wenn sie mit solchen Daten trainiert wurden. Dreißig Stellungnahmen wurden ausgewertet; der Bericht dokumentiert die eingegangenen Positionen und nicht notwendig die Auffassung der Behörde. Ein einheitliches Meinungsbild ergab sich nicht – schon die Frage, wann ein großes Sprachmodell als anonym gelten kann, wurde unterschiedlich beantwortet.
Für Kanzlei S. heißt das konkret: Hat das Modell aus mehreren hundert realen Mandantenfällen gelernt, stellt sich später die Frage, ob Informationen über einen bestimmten Mandanten noch reproduziert oder durch gezielte Abfragen rekonstruiert werden können. Wer diese Frage erst nach dem Training stellt, stellt sie zu spät.
"Berechtigtes Interesse" ist keine Formel, die man unter ein fertiges Projekt schreibt.
Besonders kritisch wird es bei der Rechtsgrundlage.
In KI-Projekten fällt schnell der Verweis auf Art. 6 Abs. 1 lit. f DSGVO. Das kann tragen – der EDSA hat berechtigte Interessen für Entwicklung und Einsatz von KI-Modellen nicht ausgeschlossen. Es ist aber keine Standardbegründung nach dem Muster: "Wir wollen effizienter arbeiten, also dürfen wir unsere historischen Daten trainieren."
Erforderlich ist eine strukturierte Prüfung in drei Schritten.
-
Legitimes Interesse. "Wir möchten KI einsetzen" genügt nicht. Tragfähig wäre etwa das Ziel, die Bearbeitungszeit bestimmter wiederkehrender steuerlicher Sachverhalte durch ein spezialisiertes internes Assistenzsystem messbar zu reduzieren.
-
Erforderlichkeit. Lässt sich dasselbe Ziel mit anonymisierten Daten, synthetischen Beispielen oder einem deutlich kleineren Datenbestand erreichen, ist kaum zu begründen, weshalb vollständige historische Mandantenakten in ein Fine-Tuning gehören.
-
Abwägung. Die Interessen und Grundrechte der betroffenen Personen sind zu gewichten, wobei deren vernünftige Erwartungen eine zentrale Rolle spielen. Ein Mandant, der seiner Kanzlei vor Jahren Unterlagen für eine Einkommensteuererklärung übergeben hat, rechnet nicht ohne Weiteres damit, dass diese Daten später als Trainingsmaterial dienen. Beratungszweck und Trainingszweck liegen erheblich auseinander. Genau diese Zweckverschiebung ist zu untersuchen.
An der zweiten Stufe scheitern die meisten Vorhaben – und der unangenehme Satz dazu lautet: Ein großer Teil der Fine-Tuning-Projekte in Kanzleien wird nicht deshalb unzulässig, weil die Interessenabwägung knapp ausgeht, sondern weil die Erforderlichkeit nie ernsthaft geprüft wurde. Wer zuerst trainiert und dann begründet, produziert keine Rechtsgrundlage, sondern eine nachträgliche Erzählung.
Bei Kanzlei S. fällt die ehrliche Antwort auf das Warum weniger fachlich als menschlich aus: Das Archiv war da, die Rechenleistung war gekauft, und niemand wollte der Erste sein, der bremst.
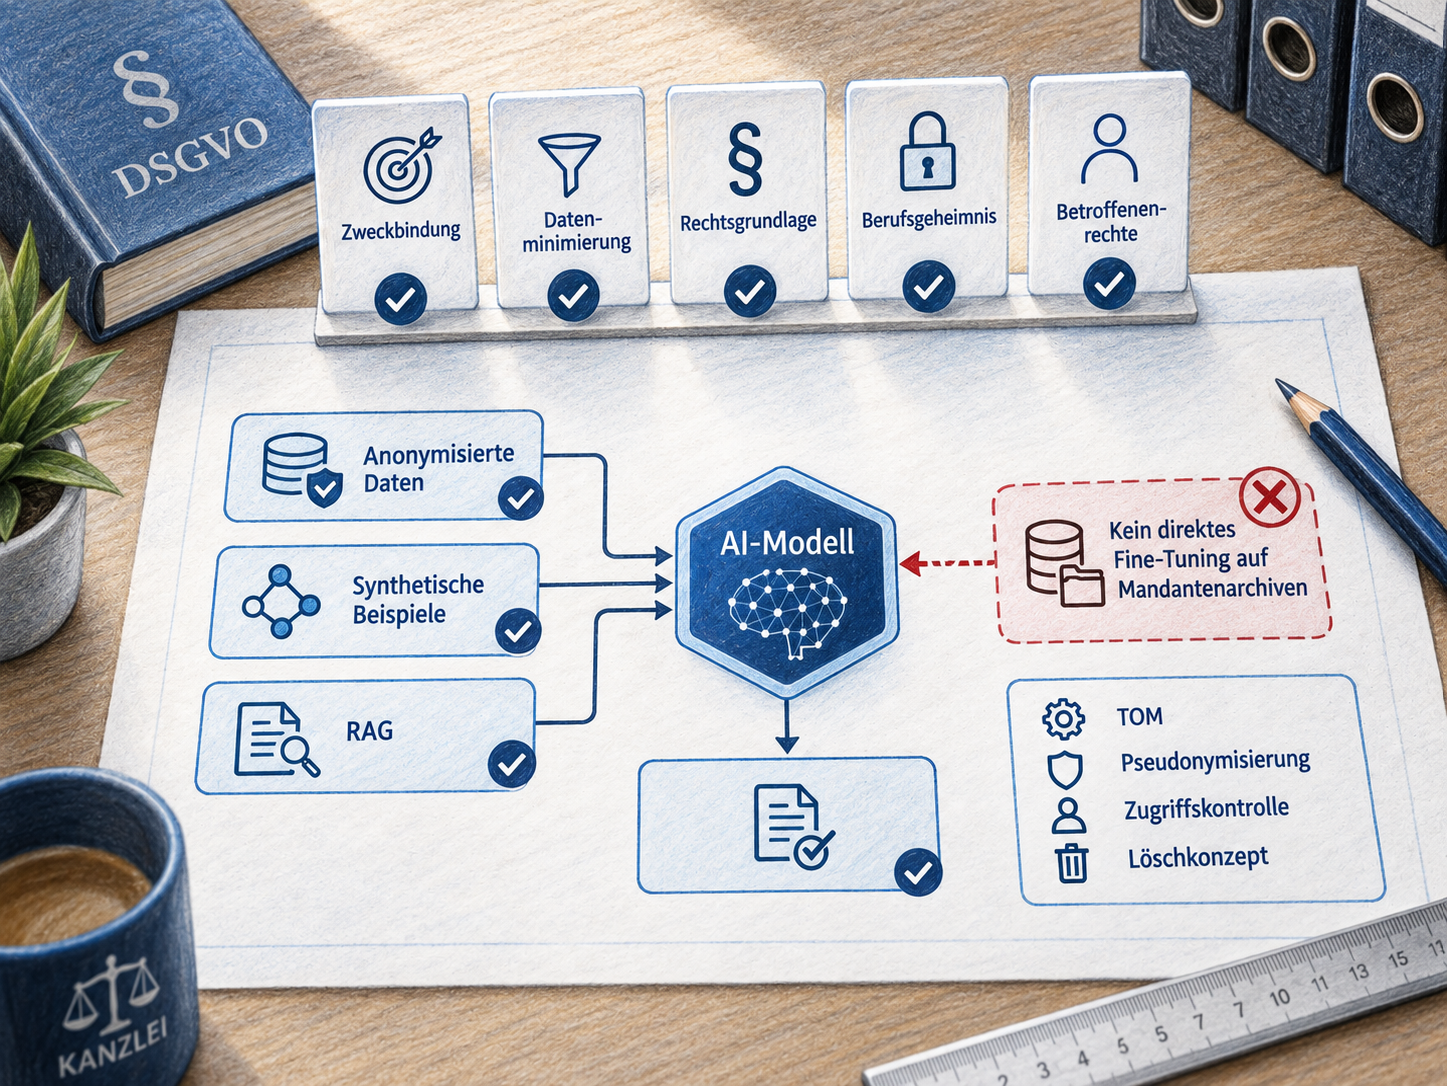
Dabei gibt es einen technisch völlig anderen Weg, der in der Praxis oft ausreicht: Retrieval Augmented Generation, kurz RAG. Dabei wird das Modell gar nicht mit den Kanzleidaten trainiert. Es bekommt sie erst im Moment der Anfrage vorgelegt. Das System durchsucht die Dokumentenablage, greift die passenden Stellen heraus und reicht sie dem Sprachmodell zusammen mit der Frage. Das Modell formuliert die Antwort – und behält nichts davon. Wer einen Zugriff sperrt, sperrt ihn wirklich. Das gilt allerdings für das Modell; ob Protokolle, Caches und Zwischenspeicher des Gesamtsystems ebenso sauber sind, ist eine eigene Frage.
(KI-generierte Illustration)
Datenschutz bestanden, Berufsrecht durchgefallen.
Für Berufsgeheimnisträger reicht die DSGVO ohnehin nicht. Steuerberater unterliegen nach § 57 Abs. 1 StBerG einer umfassenden Verschwiegenheitspflicht, konkretisiert durch § 5 BOStB; Wirtschaftsprüfer trifft die entsprechende Pflicht nach § 43 Abs. 1 Satz 1 WPO. Beide zählen ausdrücklich zu den in § 203 StGB erfassten Berufsgeheimnisträgern. Eine Verarbeitung kann datenschutzrechtlich zulässig sein und berufsrechtlich trotzdem scheitern.
Für Kanzlei S. beginnt die Prüfung mit einer guten Nachricht. Das Berufsrecht kennt keine Kategorie "Serverstandort" – es fragt nach Personen. § 62a Abs. 1 Satz 2 StBerG definiert den Dienstleister als "andere Person oder Stelle, die vom Steuerberater ... mit Dienstleistungen beauftragt wird"; für Wirtschaftsprüfer gilt § 50a WPO parallel. Wo niemand beauftragt wird, gibt es nichts vertraglich zu verpflichten – praktisch erheblich, denn die Vertragsanbahnung mit großen Anbietern ist häufig schlicht nicht durchsetzbar.
Nur ist reines Self-Hosting selten rein. Angemietete Rechenkapazität, Fernwartung, Backup, der Support des Modellanbieters – jeder dieser Zugänge ist eine Person oder Stelle im Sinne der Norm. Die Dienstleisterfrage verschwindet dann nicht, sie wandert zu den Randdiensten und wird dort regelmäßig übersehen. Die Wirtschaftsprüferkammer denkt diese Kette ausdrücklich mit und verlangt bei Plattformanbietern mit KI-Subunternehmern Regelungen nach § 50a Abs. 3 Satz 2 Nr. 3 Hs. 2 WPO.
Sobald jemand hinzukommt, gelten die vollen Anforderungen: sorgfältige Auswahl und vertragliche Verschwiegenheitsverpflichtung vor jedem Zugang, bei ausländischen Anbietern ein vergleichbares Schutzniveau. Eine Einwilligung des Mandanten macht das nicht entbehrlich – sie entfällt nur bei ausdrücklichem Verzicht. Dient der Einsatz unmittelbar einem einzelnen Mandat, verlangt § 62a Abs. 5 StBerG die Einwilligung sogar zusätzlich; ob diese Sonderregel auf generative KI passt, hält die BStBK selbst für nicht zweifelsfrei beantwortbar und empfiehlt im Zweifel Einwilligung oder Anonymisierung.
Wie wenig der Standort entscheidet, zeigt die WPK-Systematik. Sie unterscheidet nicht mehr zwischen offenen und geschlossenen, sondern zwischen ungeschützten und geschützten KI-Systemen: Geschützt ist eine Anwendung, wenn technisch-organisatorisch und vertraglich sichergestellt ist, dass Berufsgeheimnisse weder in öffentliche Modelle einfließen noch unbefugten Dritten bekannt werden – ausdrücklich "sei es in der Cloud oder 'on premise'". Ein Cloud-System kann geschützt sein, ein hausinternes ungeschützt, etwa wenn Zugriffsrechte fehlen oder Wartungszugänge offenstehen. On-Premise ist ein möglicher Weg dorthin, nicht die Definition.
Und hier kippt die gute Nachricht. Was der Eigenbetrieb an Vertragsarbeit erspart, holt er an Organisationspflichten zurück. § 62 StBerG verlangt, die Beschäftigten in Textform zur Verschwiegenheit zu verpflichten, über die strafrechtlichen Folgen zu belehren und "in geeigneter Weise auf die Einhaltung hinzuwirken" – die KI-Richtlinie ist damit kein Papier für die Aufsicht, sondern Erfüllung einer Berufspflicht. Die WPK verlangt, dass sich das Qualitätssicherungssystem auf die eingesetzten KI-Anwendungen erstreckt, ausdrücklich auf "selbst entwickelte wie auch 'eingekaufte'". Und die BStBK führt in ihrem Muster-KI-Verzeichnis ein "Kanzlei-GPT mit RAG (intern)" als Beispielzeile: Interne Eigenlösungen sind für die Kammern kein Sonderfall außerhalb der Governance, sondern ihr Regelfall.
Dass nicht jede Schranke einen Dritten voraussetzt, zeigen die Verwertungsverbote nach § 323 Abs. 1 Satz 2 HGB und § 11 BS WP/vBP: Sie untersagen die Verwertung "weder für sich noch für Dritte", richten sich also auch gegen den Berufsträger selbst. Für den Trainingsfall entschärft die WPK sie deutlich – sie betreffen außerberufliche Zwecke, nicht das Lernen aus dem Mandat zur Verbesserung der eigenen fachlichen Kenntnisse, ausdrücklich auch unter Zuhilfenahme von KI.
Unter dem Strich löst Self-Hosting genau einen Problemkreis: die Offenbarung an Externe. Die Verschwiegenheitspflicht bleibt ortsunabhängig, die Organisationspflichten wachsen eher, und wer selbst betreibt, kann sich auf keine Anbieterzusicherung berufen. Self-Hosting verschiebt Verantwortung nach innen. Es reduziert sie nicht.
Die unangenehmste Frage: Bekommen wir Frau K. wieder aus dem Modell?
Nehmen wir an, Kanzlei S. hat trainiert. Zwei Monate später kündigt eine Mandantin – nennen wir sie Frau K. – das Mandat und macht datenschutzrechtliche Ansprüche geltend. Die Kanzlei löscht ihre Akte, soweit keine gesetzlichen Aufbewahrungspflichten entgegenstehen. Offen bleibt, was mit den Informationen geschieht, die in das trainierte Modell eingeflossen sind.
Und hier hilft der Hinweis auf Aufbewahrungspflichten nicht weiter. § 66 StBerG und die steuerlichen Fristen verpflichten zur Aufbewahrung von Handakten und Unterlagen – sie rechtfertigen nicht, dass Muster aus den Daten einer Mandantin in den Parametern eines Modells verbleiben. Das Training ist eine eigene Verarbeitung mit eigenem Zweck und braucht eine eigene Begründung.
In einer Datenbank lässt sich ein Datensatz vergleichsweise einfach lokalisieren. In einem trainierten neuronalen Modell ist das ungleich schwieriger. Technisch diskutiert werden vollständiges Retraining ohne die betreffenden Daten, Machine-Unlearning-Verfahren sowie ergänzende Maßnahmen gegen unerwünschte Ausgaben wie Output-Filter oder das Blockieren bestimmter Prompts. Keine dieser Lösungen erlaubt derzeit die pauschale Aussage, eine bestimmte Person lasse sich mit derselben Sicherheit aus einem Modell entfernen wie aus einer relationalen Datenbank. In der Konsultation der Bundesbeauftragten für den Datenschutz und die Informationsfreiheit wurde genau das sichtbar: Maßnahmen zur Reduktion des Extraktionsrisikos wurden vielfach benannt, eine belastbare Entfernungsgarantie nicht.
Ein Löschkonzept darf deshalb nicht erst entstehen, wenn der erste Betroffene anfragt. Die Frage gehört vor das Training.
Dabei ist zu differenzieren: Der Löschungsanspruch nach Art. 17 DSGVO besteht nicht schrankenlos, gesetzliche Aufbewahrungspflichten und andere Ausnahmetatbestände können ihm entgegenstehen. Entscheidend ist nicht, dass jede Löschung gelingt – entscheidend ist, dass eine Kanzlei weiß, wo personenbezogene Daten verarbeitet werden und wie sie Betroffenenrechte technisch umsetzen kann. Wer auf die Frage "Was tun wir bei einem Auskunftsersuchen zum Modell?" keine Antwort hat, hat kein Löschkonzept, sondern eine Hoffnung.
Die Folgenabschätzung gehört vor das Training – nicht hinterher in den Projektordner.
Je größer und sensibler der Trainingsdatenbestand, desto stärker rückt Art. 35 DSGVO in den Vordergrund. Eine Datenschutz-Folgenabschätzung ist erforderlich, wenn eine Verarbeitung voraussichtlich ein hohes Risiko für die Rechte und Freiheiten natürlicher Personen zur Folge hat. Ob die Schwelle erreicht ist, beurteilt sich im Einzelfall – bei umfangreichen Trainingsbeständen mit Mandanten- oder Beschäftigtendaten wird die Prüfung kaum ernsthaft entbehrlich sein.
Die BStBK weist darauf hin, dass Aufsichtsbehörden eine DSFA beim KI-Einsatz vielfach erwarten und Kanzleien dafür auf Angaben des Anbieters zu Funktionsweise und Trainingsdaten angewiesen sind. Bei einem selbst trainierten Modell gibt es diesen Anbieter nicht – die Kanzlei muss Herkunft, Zusammensetzung und Verarbeitung der Trainingsdaten vollständig selbst dokumentieren. Und die Kammer zieht eine Konsequenz, die viele kleinere Kanzleien überrascht: Ist eine DSFA erforderlich, sind auch sie zur Bestellung eines Datenschutzbeauftragten verpflichtet.
Hier zeigt sich der praktische Fehler vieler KI-Projekte: Zuerst wird die Machbarkeit getestet, dann folgt die rechtliche Bewertung. Für ein Training mit echten Kanzleidaten ist die Reihenfolge umzudrehen.
Und dann ist da noch die KI-Verordnung.
Die EU-KI-Verordnung (KI-VO) knüpft nicht an den Serverstandort an. Seit dem 2. Februar 2025 verlangt Art. 4 von Anbietern und Betreibern, ein ausreichendes Maß an KI-Kompetenz ihres Personals sicherzustellen. Eine Kanzlei, die KI eigenverantwortlich einsetzt, ist dabei in der Regel Betreiberin im Sinne von Art. 3 Nr. 4 KI-VO – die Pflicht trifft sie also unabhängig davon, ob das Modell im eigenen Serverraum oder bei einem Anbieter läuft. Die Fortbildungspflicht aus § 57 Abs. 2a StBerG läuft daneben und deckt denselben Gegenstand von der berufsrechtlichen Seite ab.
Fünf Prüfungen vor dem ersten Fine-Tuning.
Daraus lässt sich für Steuerberater- und WP-Kanzleien eine klare Vorgehensweise ableiten.
Zweck definieren. Beschreiben Sie konkret, welches Problem das eigene Modell lösen soll. "Eigene Kanzlei-KI aufbauen" ist kein Verarbeitungszweck.
Daten minimieren. Prüfen Sie, ob personenbezogene Mandantendaten überhaupt erforderlich sind. Wo anonymisierte Fälle, synthetische Daten, fachliche Musterdokumente oder ein RAG-System genügen, sollten reale Mandantendaten gar nicht erst in das Modell gelangen.
Rechtsgrundlage und Zweckkompatibilität klären. Halten Sie vor dem Training fest, weshalb die Daten für diesen neuen Zweck verarbeitet werden dürfen. Wer sich auf berechtigte Interessen stützt, dokumentiert die Interessenabwägung – schriftlich, datiert, nachvollziehbar.
Datenschutz, Berufsrecht und KI-VO getrennt prüfen. DSGVO-Konformität ersetzt weder § 203 StGB noch § 57 Abs. 1 StBerG. Verpflichten Sie die Beschäftigten nach § 62 StBerG und regeln Sie den KI-Einsatz im Qualitätssicherungssystem. Und gehen Sie die Liste der Beteiligten ehrlich durch: Auch Rechenzentrum, Fernwartung und Backup sind Dienstleister im Sinne von § 62a StBerG beziehungsweise § 50a WPO. Bei Wirtschaftsprüfern kommen die Verwertungsverbote hinzu, und die Pflichten aus der KI-VO laufen unabhängig davon weiter.
Betroffenenrechte technisch durchspielen. Stellen Sie vor dem Training einen konkreten Testfall: Was tun wir, wenn morgen jemand Auskunft, Berichtigung, Widerspruch oder – soweit einschlägig – Löschung verlangt? Kann niemand einen technisch belastbaren Prozess beschreiben, ist das Projekt nicht produktionsreif.
Kanzlei S. ist an der zweiten Prüfung hängengeblieben. Das war kein Rückschlag, sondern das Ergebnis.
Self-Hosting ist ein Schutzmechanismus – kein Compliance-Konzept.
Eine eigene KI-Infrastruktur kann für Steuerberater und Wirtschaftsprüfer eine sehr sinnvolle Architekturentscheidung sein. Gerade bei hochvertraulichen Informationen verbessert sie die Kontrolle über Datenzugriffe und reduziert bestimmte Drittland- und Dienstleisterrisiken. Nur darf man sie nicht mit Datenschutzkonformität verwechseln.
Der Perspektivwechsel lautet deshalb: Nicht zuerst fragen Wo läuft unser Modell?, sondern Welche Daten bringen wir hinein, warum dürfen wir das – und wie bekommen wir sie wieder heraus?
Kanzlei S. hat das Fine-Tuning am Ende nicht durchgeführt. Statt das Archiv in die Modellgewichte zu schieben, entschied sie sich für den RAG-Weg. Zugriffsrechte spiegeln die Mandatsstruktur, jede Antwort weist ihre Quellen aus, und wird ein Dokument aus der Ablage genommen, ist es auch aus dem Index verschwunden. Der Aufwand war nicht kleiner – aber die Betroffenenrechte waren umsetzbar.
Die Datenschutzkonferenz hat dazu 2025 eine eigene Orientierungshilfe veröffentlicht. Sie hebt hervor, dass RAG-Systeme eigenständig entwickelt, betrieben und kontrolliert werden können, den Einsatz kleinerer und lokal betriebener Modelle ermöglichen und damit Datenschutz durch Technikgestaltung abbilden.
Zugleich enthält sie eine Warnung, die man nicht überlesen sollte: RAG beseitigt nicht die datenschutzrechtlichen Probleme eines rechtswidrig trainierten Sprachmodells, und Transparenz, Zweckbindung und Betroffenenrechte im Gesamtsystem sicherzustellen, bleibt anspruchsvoll. Auch das betrifft Kanzlei S. Was sie beim Download des Basismodells nicht mitgeliefert bekommt, ist die Antwort auf die Frage, womit dieses Modell ursprünglich trainiert wurde.
Für viele Kanzleien ist der beste Datensatz deshalb derjenige, den man gar nicht erst trainiert. Wer zuerst trainiert und anschließend nach der Begründung sucht, hat den Zeitpunkt für die wichtigste Datenschutzentscheidung bereits verpasst.
Quellenverzeichnis
Die im Text wiedergegebenen Rechtsnormen, Behördenpositionen und Kammeraussagen sind nachfolgend mit Stand und Fundstelle nachgewiesen.
-
Verordnung (EU) 2016/679 (DSGVO), insbesondere Art. 5, 6, 17, 21, 25 und 35. Quelle: intersoft consulting ag, dsgvo-gesetz.de, abgerufen am 26.08.2026.
-
Stellungnahme 28/2024 zu gewissen Datenschutzaspekten der Verarbeitung personenbezogener Daten im Zusammenhang mit KI-Modellen Europäischer Datenschutzausschuss (EDSA/EDPB) 28/2024; behandelt insbesondere, wann KI-Modelle als anonym gelten können, und die Voraussetzungen einer Verarbeitung auf Grundlage berechtigter Interessen.
-
Konferenz der unabhängigen Datenschutzaufsichtsbehörden des Bundes und der Länder (DSK): Orientierungshilfe zu datenschutzrechtlichen Besonderheiten generativer KI-Systeme mit RAG-Methode, Oktober 2025.
-
Konferenz der unabhängigen Datenschutzaufsichtsbehörden des Bundes und der Länder (DSK): Orientierungshilfe "Künstliche Intelligenz und Datenschutz", Version 1.0, 6. Mai 2024 (adressiert primär Verantwortliche).
-
Konferenz der unabhängigen Datenschutzaufsichtsbehörden des Bundes und der Länder (DSK): Orientierungshilfe "Datenschutzrechtliche Anforderungen an KI-Systeme", Juni 2025 zu empfohlenen technischen und organisatorischen Maßnahmen bei Entwicklung und Betrieb (adressiert primär Hersteller und Entwickler).
-
Bundesbeauftragte für den Datenschutz und die Informationsfreiheit (BfDI): Übersichtsseite des Verfahrens; Konsultationspapier vom 10. Juli 2025, Stellungnahmefrist 31. August 2025; Konsultationsbericht, Februar 2026.
-
Bundessteuerberaterkammer (BStBK): "FAQ: KI im steuerberatenden Berufsstand", Stand 27. Januar 2026. Zum Muster-KI-Verzeichnis: Siehe Kapitel 7, Seite 31.
-
Wirtschaftsprüferkammer (WPK): "Fragen und Antworten zum Einsatz von künstlicher Intelligenz in der WP-Praxis", Stand 21. Mai 2026.
-
Steuerberatungsgesetz (StBerG), insbesondere § 57 Abs. 1 (allgemeine Berufspflichten und Verschwiegenheit), § 57 Abs. 2a (Fortbildung) und § 62a (Inanspruchnahme von Dienstleistungen), ergänzt durch die Berufsordnung der Bundessteuerberaterkammer (BOStB), insbesondere §§ 2 bis 5. § 62 StBerG (Verschwiegenheitspflicht beschäftigter Personen); gesetze-im-internet.de (26.08.2026).
-
Strafgesetzbuch (StGB), § 203 – Verletzung von Privatgeheimnissen, mit ausdrücklicher Erfassung von Steuerberatern, Wirtschaftsprüfern und vereidigten Buchprüfern. gesetze-im-internet.de (26.08.2026).
-
Wirtschaftsprüferordnung (WPO), insbesondere § 43 Abs. 1 Satz 1 (Verschwiegenheit, Gewissenhaftigkeit, Eigenverantwortlichkeit) und § 50a (Inanspruchnahme von Dienstleistungen), sowie § 323 Abs. 1 Satz 2 HGB und § 11 BS WP/vBP zu den Verwertungsverboten. § 50a Abs. 3 Satz 2 Nr. 3 Hs. 2 WPO. gesetze-im-internet.de (26.08.2026).
-
Verordnung (EU) 2024/1689 (KI-Verordnung), insbesondere Art. 3 Nr. 4 (Betreiber), Art. 4 (KI-Kompetenz) und Art. 50 (Transparenzpflichten). Quelle: intersoft consulting ag, ai-act-law.eu/de, abgerufen am 26.08.2026.
Stand: August 2026. Die zitierten Kammerveröffentlichungen werden fortlaufend aktualisiert; vor einer Verwendung im Mandat sollte die jeweils aktuelle Fassung geprüft werden. Der Beitrag dient der allgemeinen fachlichen Information und ersetzt keine rechtliche Prüfung des Einzelfalls. Das geschilderte Kanzleibeispiel ist ein typisiertes Szenario und kein dokumentierter Einzelfall.